
Закон Ципфа онлайн: проверка текста и анализ отклонений графика
Закон Ципфа давно перестал быть академической диковинкой и превратился в практический инструмент. Суть в том, что в естественном тексте частота слова примерно обратно пропорциональна его рангу в частотном списке: самое частое слово встречается вдвое чаще второго, втрое чаще третьего. Именно поэтому анализ текста по закону Ципфа позволяет редакторам, исследователям и SEO-специалистам увидеть, написан ли материал живым автором или собран из шаблонных блоков. Родительская статья уже показала базовую логику: отклонение от ожидаемого распределения — повод присмотреться, а не приговор. Здесь разберём, как провести проверку на практике и что означают отклонения на графике.
Компания PromoPilot™ предлагает бесплатные инструменты для такой проверки, но метод не привязан к конкретному сервису: та же картина строится в электронной таблице или скриптом на Python. Важно лишь соблюдать одинаковые правила подготовки для всех сравниваемых текстов, иначе выводы теряют смысл.
Что понадобится для проверки
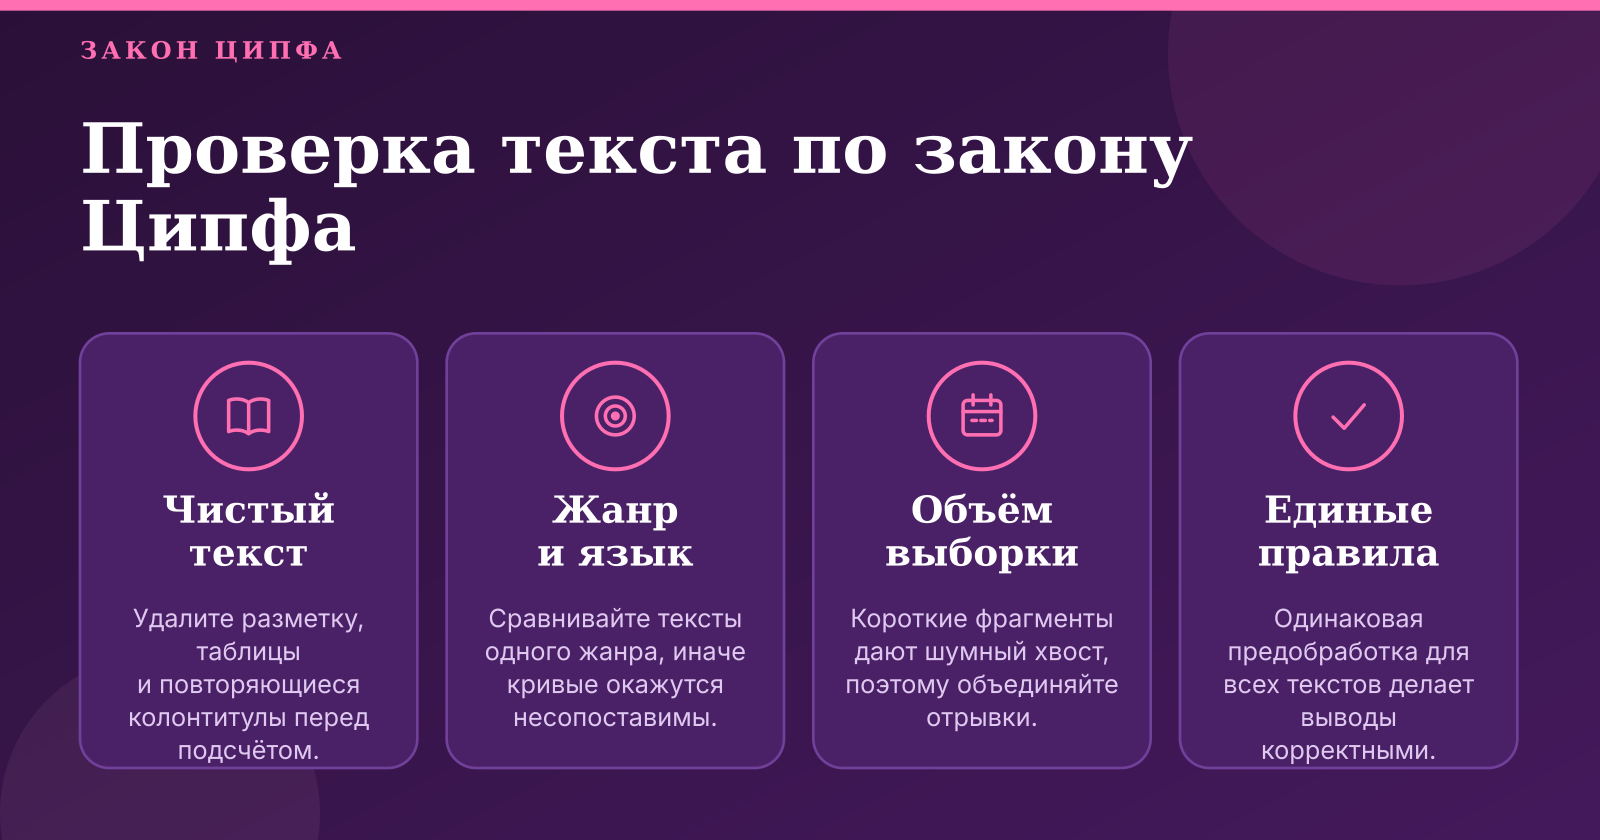
Первое условие — текст в чистом виде. Служебная разметка, таблицы, фрагменты кода и повторяющиеся колонтитулы дают ложные частоты: например, слово из навигационного меню начнёт попадать в топ распределения только потому, что повторяется на каждой странице. Поэтому сначала удаляются HTML-теги, сноски и вставки, не относящиеся к основному тексту.
Второе — инструмент подсчёта. Подойдёт онлайн-анализатор частоты слов либо несложный скрипт с токенизацией и функцией подсчёта. Для проверки достаточно вычислить абсолютные частоты, отсортировать их по убыванию и построить график. Третье — единая предобработка: решение о регистре, знаках препинания, числах и стоп-словах принимается до начала подсчёта и применяется ко всем текстам одинаково. Четвёртое — ориентир для сравнения: эталонный корпус того же языка и жанра. Закон Ципфа нельзя оценивать в вакууме: технический справочник и новостная заметка будут выглядеть по-разному даже при честном авторстве.
Подготовка исходного текста и выбор языка
Закон формулируется для естественных текстов, а не для списков терминов, таблиц или перечней товаров. Если в тексте много однотипных блоков, распределение исказится, и это не будет связано с качеством письма. Поэтому перед анализом стоит определить жанр и язык: статья, пресс-релиз, инструкция и переписка дают разные кривые, и сравнивать их напрямую некорректно.
Отдельно фиксируется объём выборки. Короткие тексты дают шумный хвост распределения: большинство слов встречаются по одному разу, и наклон графика в этой области мало о чём говорит. Практическое правило, которым пользуются при ручной проверке, — не анализировать фрагменты короче двух сотен слов и по возможности объединять несколько отрывков одного автора. Чем длиннее текст, тем устойчивее оценка.
Правила токенизации
Токенизация — это ответ на вопрос, что считать словом. Для русского языка главный выбор — словоформы или леммы. Без лемматизации «ссылка», «ссылки» и «ссылку» учитываются как три разных слова, и тема, занимающая заметное место, распадается на несколько строк с низкими частотами. Лемматизация объединяет их, и распределение становится честнее. Но у неё есть цена: лемматизатор иногда ошибается, и результат зависит от его качества.
Дефисные и сложные слова нужно решить заранее: считать ли «онлайн-проверка» одним токеном или двумя. Числа, аббревиатуры, никнеймы и имена собственные тоже требуют правила. Если в тексте много цифр и дат, их лучше исключить, иначе они займут верхние строки и исказят картину. Главное правило — одинаковые настройки для всех текстов. Сравнение, где один документ обработан с лемматизацией, а другой без неё, бессмысленно.
Порядок действий: от частот к рангам
Алгоритм простой и воспроизводимый. Текст разбивается на токены по выбранным правилам. Подсчитываются абсолютные частоты, и составляется список, отсортированный по убыванию. Каждому слову присваивается ранг r, начиная с единицы. Затем строится график в двойных логарифмических координатах: логарифм ранга по горизонтали, логарифм частоты по вертикали. Для естественного текста точки ложатся примерно на прямую с наклоном, близким к минус единице.
Логарифмическая шкала нужна не для красоты: она превращает степенную зависимость в прямую, а отклонения от прямой становятся видны глазом. В табличном редакторе это делается добавлением двух столбцов с логарифмами и точечной диаграммой, а в Python — функцией log10 и последующей аппроксимацией.
Построение графика и оценка наклона
Наклон оценивается линейной регрессией по логарифмированным данным. Угловой коэффициент даёт оценку показателя степени, и его отклонение от −1 само по себе информативно: слишком пологая прямая указывает на то, что слова распределены более равномерно, чем обычно, а слишком крутая — на доминирование нескольких частых слов. После очистки текста полезно провести анализ текста по закону Ципфа на уровне отдельных частотных рангов, чтобы увидеть, как реальное распределение слов соотносится с ожидаемой степенной зависимостью и где именно возникают заметные отклонения.
Здесь есть техническая тонкость. Хвост списка, где частоты равны единице, визуально тянет график вниз и вносит искажение в регрессию. Поэтому сравнение разумно проводить на фиксированном диапазоне рангов, например на первых ста или первой тысяче, и использовать один и тот же диапазон для всех текстов. Иначе два документа с одинаковым поведением могут получить разные наклоны только из-за разного объёма.
На что смотреть при чтении отклонений
Отклонения читаются по форме кривой. Излом в начале распределения обычно связан со служебными словами: если стоп-слова удалены частично или не удалены вовсе, верхушка выглядит иначе, чем в эталоне. Пологий участок в середине может говорить о тематической однородности или о повторяющемся шаблоне. Крутой спад в хвосте для разреженных данных нормален, но на малой выборке он преувеличен, поэтому сначала стоит проверить объём.
Самый показательный признак — ступеньки и горизонтальные полки. Они возникают, когда одни и те же фрагменты дублируются или когда текст собран из блоков с одинаковой лексикой. Ещё один сигнал — резкое изменение наклона при сравнении двух частей одного документа. Если первая половина ведёт себя как естественный текст, а вторая заметно отклоняется, стоит проверить, не смешаны ли разные авторы, жанры или источники. Такое расхождение часто оказывается следом склейки, а не стилистической особенностью.
Систематическое отклонение не равно ошибке: оно может отражать реальную структуру текста. Поэтому каждое отклонение интерпретируется вместе с объёмом выборки, языком и правилами подготовки, а не само по себе.
Типичные ошибки и способы их избежать
Первая ошибка — сравнение текстов разного объёма без ограничения диапазона рангов. Длинный документ неизбежно получит более пологий хвост, и на этом фоне короткий текст будет выглядеть подозрительно. Вторая — смешение словоформ и лемм в одном подсчёте. Третья — оценка по всему списку без учёта шумного хвоста, из-за которой наклон дрожит от случайных колебаний.
Четвёртая ошибка — интерпретация любого отклонения как доказательства подделки или машинной генерации. Отклонение указывает, что стоит присмотреться, но не отвечает, кто написал текст. Пятая — использование закона для фрагментов, где статистики недостаточно, и замена проверки графика визуальным впечатлением без численной оценки наклона. Оба подхода дают уверенность, которой данные не подтверждают.
Практический чеклист перед выводами
- Текст очищен от разметки, колонтитулов и служебных элементов.
- Правила токенизации записаны и применены одинаково ко всем документам.
- Решено, учитываются ли стоп-слова, числа и имена собственные.
- Построен график в двойных логарифмических координатах.
- Наклон оценён на фиксированном диапазоне рангов.
- Хвост распределения проверен на артефакты подсчёта.
- Отклонения сопоставлены с объёмом выборки и жанром.
- Вывод сделан на сравнении с эталонным корпусом, а не только по абсолютному значению наклона.
Для быстрой первичной картины удобно использовать онлайн-инструменты: например, сервис PromoPilot™ строит частотный список и график без установки программ. Но итоговое решение всё равно опирается на сравнение и на чтение отклонений, а не на одно число.
Заключение и практические выводы
Закон Ципфа работает как диагностический инструмент: он показывает структуру частот и подсказывает, куда смотреть, но не даёт окончательного вердикта о качестве или авторстве. Ценность метода в правильном чтении отклонений и в воспроизводимой процедуре, где каждое решение о подготовке текста зафиксировано и применено одинаково.
Если следовать этой логике, проверка становится надёжным элементом редакторского контроля и SEO-аудита. Начинать стоит с чистого текста достаточного объёма, фиксировать правила токенизации, строить график на фиксированном диапазоне рангов и сравнивать результат с живыми образцами того же жанра. Тогда отклонение превращается в конкретный вопрос к тексту, а не в поспешный вывод о нём.