
Закон Ципфа онлайн: как проверить текст и читать отклонения
Закон Ципфа давно перестал быть курьёзом из учебника по лингвистике и стал рабочим инструментом: им пользуются редакторы, SEO-аналитики и те, кто проверяет, кто написал текст — человек или нейросеть. Суть проста. Если взять достаточно большой естественный текст, подсчитать частоту каждого слова и выстроить слова по убыванию частоты, то частота окажется обратно пропорциональной рангу. Самое частое слово встретится примерно вдвое чаще второго, втрое чаще третьего и так далее. Этот порядок почти не зависит от темы и жанра, поэтому отклонение от него — сигнал, который стоит разобрать. Ниже разберём формулу, способы проверки текста, ручной расчёт на графике log-log и то, как читать отклонения, не делая поспешных выводов. Для быстрой проверки удобна проверка Ципфа онлайн, но понимать, что именно считает инструмент, полезнее, чем просто смотреть на итоговый процент.
Закон Ципфа: что он описывает и почему его применяют к тексту
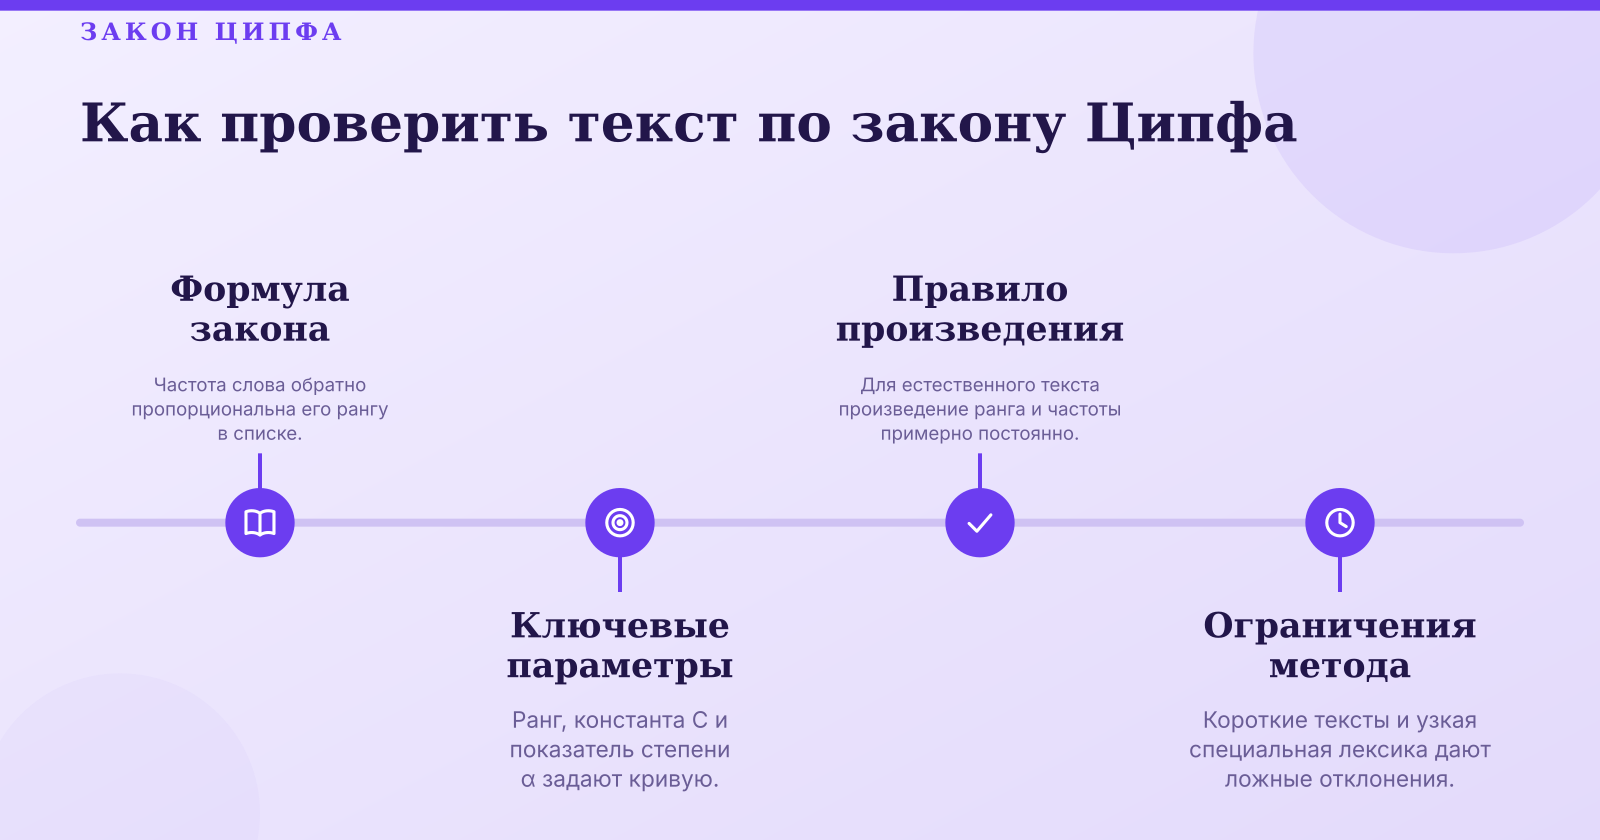
Формула закона записывается как f(r) = C / r^α, где f — частота слова, r — его ранг, C — константа, близкая к частоте самого частого слова, а α для естественного языка обычно близко к единице. Смысл каждого параметра важен на практике. Ранг — это место слова в списке, отсортированном по убыванию частоты: «в» или «и» стоят первыми, тематические существительные ниже. Константа C задаёт масштаб: в длинном тексте она будет больше, чем в коротком. Показатель степени определяет крутизну кривой: чем он ближе к единице, тем более «естественным» выглядит распределение.
- В списке обнаруживается, что тематический термин стоит почти на первом месте и его частота близка к частоте первого служебного слова
- В-третьих, тематика: технический или юридический текст будет отклоняться сам по себе
- Закон Ципфа хорош как первый сигнал и как количественное подтверждение того, что текст стоит изучить внимательнее
- Проверить текст можно онлайн за минуту или вручную за час, но в обоих случаях важнее не число, а причины отклонения
Из формулы следует удобное правило: произведение ранга на частоту r × f для естественного текста примерно постоянно. Если в тексте слово на пятом месте встречается в три раза реже, чем слово на первом, это нормально. Если же слово на втором месте встречается почти так же часто, как первое, распределение «ломается», и именно такие места ищут аналитики.
Почему закон вообще работает для текста? Причина в том, что язык экономит усилия: короткие служебные слова употребляются постоянно, а содержательные слова с узкой семантикой — реже. Говорящие и пишущие интуитивно балансируют между понятностью и краткостью, и в итоге возникает характерная степенная зависимость. Она проявляется не только в языке: похожие распределения встречаются в размерах городов и в объёмах посещаемости сайтов, но для текстов закономерность особенно устойчива.
Важно честно сказать, где закон работает плохо. На очень коротких фрагментах, например на десяти заголовках, частоты слишком малы, и кривая просто не успевает сложиться. Специализированная лексика — инструкции, юридические договоры, списки артикулов — сильно отклоняется от нормы, потому что повторяемость там заложена жанром. Программный код и таблицы вообще не являются естественным текстом. Поэтому отклонение само по себе ничего не доказывает: сначала нужно понять, каким был жанр и объём текста.
Как выбрать инструмент для проверки текста по закону Ципфа онлайн
Прежде чем загружать текст в любой сервис, полезно понять несколько критериев. Первый — язык и морфология. Для русского языка без лемматизации картина искажается: слова «ссылка», «ссылки», «ссылку» считаются разными, и распределение выглядит более «рваным», чем есть на самом деле. Поэтому сервис, который умеет приводить слова к начальной форме, даёт более честный результат, а сервис, который этого не делает, стоит воспринимать как грубую оценку.
Второй критерий — длина текста на входе. Большинство показателей становятся надёжными только на нескольких сотнях слов. Хороший инструмент должен прямо говорить о минимальном объёме и не выдавать уверенный вывод по трём предложениям. Третий критерий — прозрачность расчётов: видно ли график ранг—частота, наклон, коэффициент детерминации, список самых частых слов с ожидаемыми значениями. Инструмент, который выдаёт только одно число без пояснений, не даёт возможности проверить логику.
Четвёртый критерий — экспорт и место обработки. Если текст конфиденциален, стоит смотреть, выполняется ли расчёт в браузере или текст отправляется на сервер. Пятый — возможность сравнивать результаты: один текст можно проверить по закону Ципфа несколько раз после правок, и тогда видно, как меняется распределение.
Теперь о типах инструментов. Есть AI-детекторы, которые считают закон Ципфа одним из десятков признаков и выводят общую оценку происхождения текста. Есть частотные анализаторы, которые строят саму кривую и подсветку повторов и не делают выводов о генерации. Задачи у них разные. Анализатор отвечает на вопрос «как устроено распределение слов», детектор — на вопрос «похож ли текст на машинный». Ошибка многих пользователей — считать, что высокий процент по одной метрике доказывает ИИ-происхождение. Корректный вывод из отклонения звучит иначе: текст требует внимания и ручной проверки.
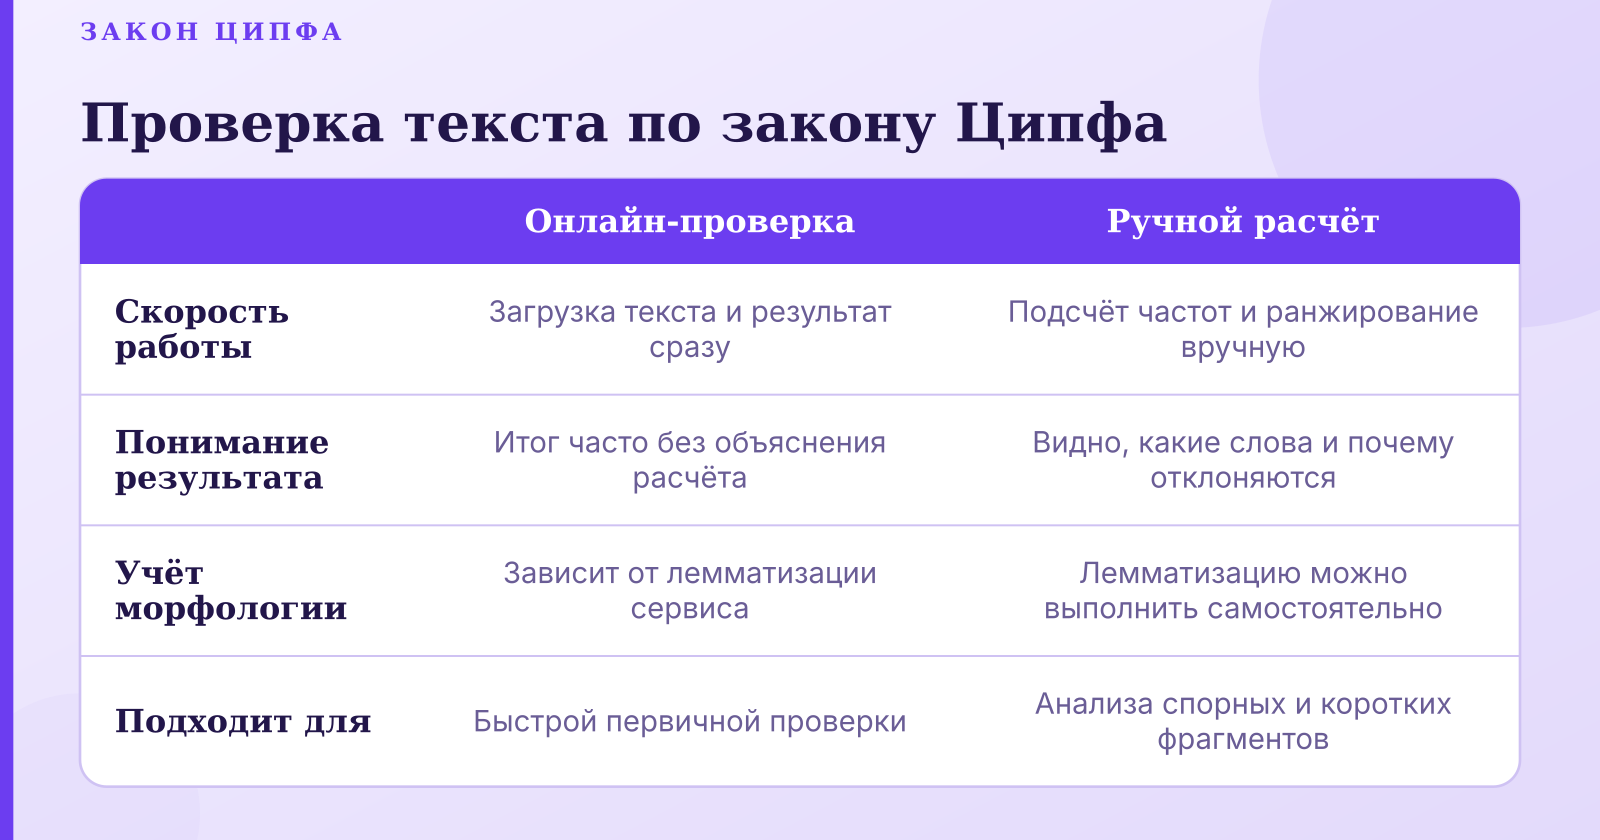
Наконец, есть выбор между подходами. Онлайн-проверка подходит для быстрой оценки одного-двух текстов. Ручной расчёт в таблице нужен, когда важно понимать каждый шаг и контролировать подготовку данных. Скрипт на Python удобен для массовой обработки десятков текстов, например при приёмке материалов от подрядчиков. Выбор зависит от объёма: один текст чаще проверяется онлайн, партия из сотни — скриптом.
Ручной анализ по частотному словарю и график log-log
Ручная проверка даёт то, что не даёт ни один отчёт, — возможность видеть саму кривую и отдельные слова, которые её искажают. Алгоритм простой, но требует внимательности на подготовке данных.
Сначала текст токенизируют: разбивают на слова, приводят к нижнему регистру, убирают знаки препинания, цифры и разметку. Затем, для русского языка, желательно выполнить лемматизацию, чтобы разные формы одного слова попали в один счётчик. Далее считают частоту каждого слова и сортируют список по убыванию. Номер строки становится рангом.
Дальше строят график в логарифмических координатах: по горизонтали откладывают log10(ранг), по вертикали log10(частота). Для естественного текста точки ложатся примерно на прямую с наклоном около −1. Наклон удобно посчитать функцией НАКЛОН (SLOPE) в Excel или Google Таблицах, а коэффициент детерминации — функцией RSQ. Чем выше R², тем плотнее точки лежат на прямой.
Подгонка прямой методом наименьших квадратов делает то же самое, что функция наклона: находит прямую, при которой сумма квадратов отклонений минимальна. Это важно понимать, потому что крайние точки — редкие слова хвоста — сильно влияют на результат. Если хвост слишком ровный или, наоборот, обрывается, наклон меняется заметно.
По времени вручную на тексте в несколько тысяч слов подготовка и подсчёт занимают от получаса до часа, если лемматизация делается без автоматики. Десятки тысяч слов разумнее обрабатывать скриптом: ручное лемматизирование такого объёма становится непрактичным. Ручной способ оправдан, когда нужно разобрать один спорный текст до последнего слова.
Как читать отклонения от закона Ципфа
Наклон прямой — главный ориентир. Наклон заметно круче −1 означает, что верхние слова доминируют: текст опирается на узкий набор повторяющихся слов, словарь беден или намеренно сужен. Наклон заметно положе означает обратное: распределение слишком ровное, слов много, и они употребляются почти равномерно. Оба варианта встречаются у естественных текстов, но в каждом случае нужно смотреть на жанр.
Отклонение от закона Ципфа — это не приговор тексту, а повод спросить, почему распределение выглядит именно так.
Теперь о характерных отклонениях. «Горб» в начале кривой — это несколько слов из верхнего ранга с частотами, почти равными друг другу. Обычно так выглядит переспам: ключевой запрос вставлен в каждое предложение, и он занимает место, которое в естественном тексте принадлежало бы служебным словам. Излом в хвосте — резкое обрывание или, наоборот, неестественная ровность редких слов. Плоские участки на средних рангах говорят о том, что частоты слишком похожи, то есть слова употреблены однообразно. Чтобы проверить такой текст самостоятельно, можно воспользоваться проверкой Ципфа онлайн, которая строит распределение частот слов и показывает, где отклонения от ожидаемой закономерности выходят за пределы обычного.
Главное — различать естественное отклонение и признаки машинной генерации, переработки или искусственного наполнения. Естественное отклонение объясняется жанром и темой: технический мануал, список терминов или текст с большим количеством имён собственных будут выглядеть иначе, чем эссе. Признаки искусственного происхождения — это сочетание факторов: ровный хвост, отсутствие характерного «пика» служебных слов, повторяющиеся обороты и высокий процент по другим метрикам. Ни один из них в отдельности не является доказательством.
Практически полезно сравнить текст с эталоном того же жанра. Возьмите три-четыре текста, написанных людьми на ту же тему и примерно того же объёма, и постройте для них те же графики. Если ваш текст лежит в общем коридоре, отклонения не стоит драматизировать. Если он резко выбивается, пора смотреть на конкретные слова.
Типичные ошибки при проверке по закону Ципфа и способы их избежать
Ошибки подготовки данных — самые частые и самые дорогие, потому что испорченные данные дают уверенно неверный результат. Смешение регистров создаёт два счётчика для одного слова. Неправильная токенизация, например разбивка по дефисам или неучёт сокращений, искажает ранги. Стоп-слова — служебные слова — иногда удаляют, иногда нет; важно понимать, что без них верхняя часть кривой выглядит совсем иначе, и сравнивать можно только одинаково подготовленные тексты. Дубли абзацев и шаблонные блоки, например одинаковые подписи под материалами, создают искусственные пики.
Ошибки интерпретации ещё коварнее. Переоценка одного показателя — самая распространённая: наклон без R², R² без графика, процент без списка слов. Сравнение текстов разной длины и жанра без нормализации тоже даёт ложные выводы: короткая статья и многостраничный отчёт не должны сравниваться напрямую. Ещё одна ловушка — считать любое отклонение доказательством. Отклонение — это вопрос, а не ответ.
Перед выводами полезно пройти простой чек-лист: текст достаточно длинный, данные подготовлены одинаково, учтён жанр, проверены верхние слова вручную, сравнение сделано с эталоном. Если хотя бы один пункт не выполнен, результат не стоит использовать для решений о публикации или оплате работы. Тогда честнее написать «результат требует уточнения», чем принимать жёсткое решение по неполным данным.
Какие задачи решает проверка текста по закону Ципфа
Редакторы и контент-команды используют анализ для контроля однородности: когда в редакции работают несколько авторов, распределение слов помогает увидеть, что материалы написаны по одному шаблону, и понять, где нужна работа с авторами. В больших массивах текстов удобнее проверять не каждый материал вручную, а выборку, и отклонения указывают, какие статьи перечитать первыми.
SEO-специалисты и аналитики применяют закон для диагностики переспама ключевыми словами и для сравнения структуры лексики у страниц, которые занимают верхние позиции по нужному запросу. Здесь важно не копировать конкурентов, а понимать, как выглядит естественный текст именно в этой нише: тематическая лексика в технических статьях и в обзорах будет распределена по-разному.
Руководители и эксперты используют проверку при приёмке внешних материалов, исследовательских текстов и отчётов подрядчиков. Здесь закон Ципфа — один из нескольких инструментов, который помогает задать вопрос о происхождении и качестве текста, но не отвечает на него окончательно.
Практические сценарии и ограничения метода
Рассмотрим, как выглядит разбор одного текста от загрузки до вывода. Допустим, редактор получает статью примерно на шестьсот слов о ремонте ноутбуков. Он вставляет текст в анализатор, видит график и процент отклонения, затем открывает список топ-30 слов. Это классический переспам. Редактор просит автора переписать несколько предложений, заменяя повтор местоимениями и синонимами, и снова проверяет текст. После правок «горб» в начале кривой уменьшается, наклон приближается к норме, а отклонение падает. Вывод при этом формулируется осторожно: распределение стало ближе к естественному, и статью можно публиковать после обычной вычитки.
Ограничения метода важно проговорить. Во-первых, язык: для русского языка без морфологии результат грубее, чем для английского, поэтому сравнивать цифры между языками нельзя. Во-вторых, размер выборки: на коротких текстах метрика малоинформативна и подтягивается к нейтральному значению. В-четвёртых, и это самое существенное, закон Ципфа не позволяет однозначно доказать происхождение текста. Он показывает, что распределение необычно, но не говорит, кто или что его создало.
Поэтому разумно дополнять анализ другими методами: стилометрией, которая сравнивает авторский почерк по синтаксису и пунктуации, экспертной оценкой специалиста по теме, проверкой источников и фактов. Но решения о публикации, оплате или обвинениях в недобросовестности на одной метрике принимать не стоит.
Итог простой. Закон Ципфа описывает устойчивую закономерность естественного текста: частота слова обратно пропорциональна его рангу, а график log-log даёт прямую с наклоном около −1. Работайте с достаточно длинными текстами, готовьте данные одинаково, сравнивайте с эталоном того же жанра и не выносите окончательных решений по одному показателю. Тогда закон Ципфа становится тем, чем и должен быть, — точным инструментом для вопросов, а не источником поспешных ответов.