
Анализ директив и ошибок файла индексации бесплатно
Представьте, что вы открыли сайт, который внезапно перестал появляться в поиске, и первым делом проверили самый маленький файл в его структуре, о котором вспоминают в последнюю очередь. Файл robots.txt занимает несколько строк, но именно он решает, какие части сайта боты вообще станут обходить. Поэтому проверка robots.txt онлайн стала привычным первым шагом для тех, кто ведёт сайт, и причина проста: одна лишняя строка способна закрыть разделы, которые должны приносить трафик.

Важно сразу договориться о границах задачи. Онлайн-проверка показывает, что написано в файле, как эти правила читаются и есть ли среди них опасные. Она не отвечает на вопрос, доступна ли конкретная страница конкретному роботу в данную минуту. Это разные вещи, и путаница между ними порождает многие ошибки в работе с сайтами. Ниже разобрано, как устроен файл, как читать его директивы, на что смотреть в отчёте и как провести проверку без пропусков.
- Подстановочные знаки отображаются как есть и не разворачиваются в список закрытых адресов
- Поисковики обращаются к robots.txt не мгновенно: Google, как правило, кэширует его до суток, поэтому исправления вступают в силу с задержкой
- Он задаёт правила обхода, и эти правила должны соответствовать целям сайта
- Каждую правку тестируйте на реальных адресах и сверяйте результат в инструментах поисковых систем
Что такое robots.txt и как он работает
Robots.txt — текстовый файл, который лежит в корне домена, например по адресу https://example.com/robots.txt. Прежде чем загружать страницы сайта, поисковые роботы запрашивают именно этот файл и смотрят, какие пути им разрешено обходить. Это соглашение о доступе, а не механизм защиты: файл не запрещает серверу отдавать страницы, он лишь сообщает добросовестным роботам о своих пожеланиях. Недобросовестные боты могут его игнорировать, поэтому закрытый robots.txt не равен закрытой информации.
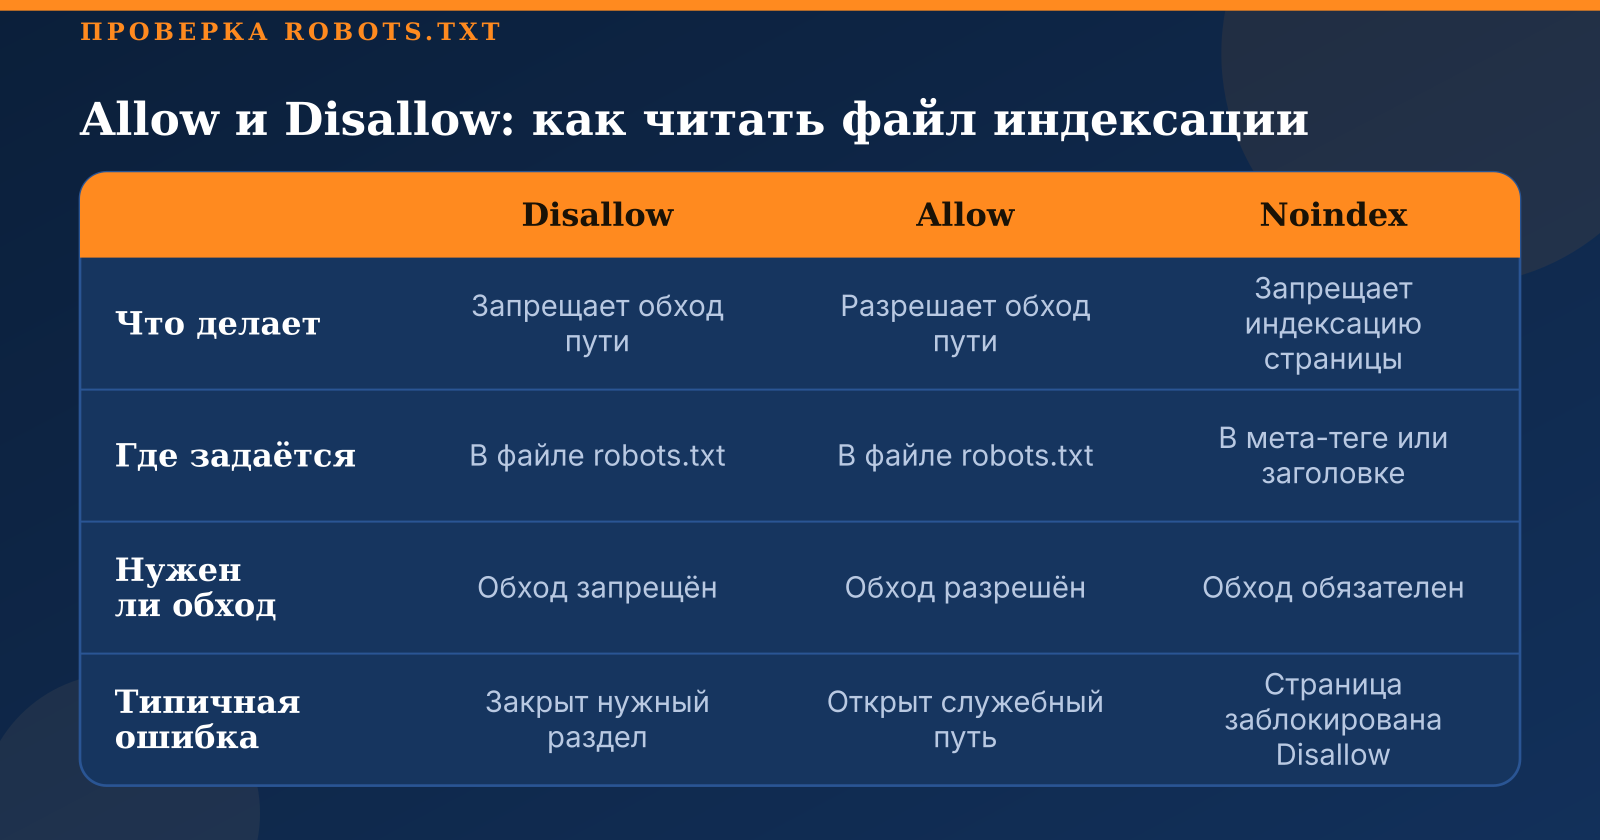
Отдельно стоит понимать различие между запретом обхода и запретом индексации. Директива Disallow говорит роботу не загружать адрес. Но если на адрес ведут внешние ссылки, поисковая система может узнать о его существовании и показать его в выдаче без описания, потому что содержимое она не читала. Чтобы страница не попала в индекс, нужен noindex в мета-теге или заголовке ответа, и для этого страница должна оставаться доступной для обхода. Запрещая обход страницы с noindex, вы лишаете поисковик возможности увидеть сам запрет индексации. Это парадокс, который часто остаётся незамеченным до тех пор, пока в выдаче не появляется то, что должно было исчезнуть.
Файл читается целиком, но по группам. Группа начинается с одной или нескольких строк User-agent, после которых идут правила Allow и Disallow. Пустые строки разделяют группы. Названия директив не чувствительны к регистру, а пути чувствительны: /Catalog/ и /catalog/ для робота — разные адреса. Поведение при разных состояниях файла тоже различается. Отсутствие файла (ответ 404) трактуется как разрешение на обход всего сайта. Пустой файл даёт тот же результат. А вот серверная ошибка 5xx при запросе robots.txt опасна иначе: поисковик может временно прекратить обход сайта целиком, чтобы не нагружать сервер и не нарушать правила, которых не может узнать. Поэтому ошибка на этом адресе серьёзнее, чем её отсутствие.
Директивы Allow, Disallow, User-agent и Sitemap на практике
Директива User-agent указывает, к какому роботу относятся последующие правила. Звёздочка означает всех роботов, которые не нашли для себя более конкретной группы. Именованные блоки, например для Googlebot или YandexBot, имеют приоритет над звёздочкой. И вот здесь кроется одна из главных ловушек: робот выполняет только самую подходящую ему группу и полностью игнорирует остальные. Если вы написали общие правила в блоке User-agent: * и добавили отдельный блок для Googlebot, то правила из общего блока для Googlebot не действуют. Их приходится дублировать в его группе. Многие владельцы сайтов обнаруживают это, когда закрытый раздел продолжает появляться в логах Googlebot.
Disallow запрещает обход путей, которые начинаются с указанного префикса. Disallow: /admin/ закроет /admin/ и всё, что в нём лежит. Пустое значение Disallow: ничего не запрещает. Allow работает наоборот, открывая путь, который иначе попал бы под запрет. Когда под одно и то же правило подходят сразу несколько директив, поисковые системы, в частности Google, берут самое длинное совпадение, то есть самое конкретное правило. При равной длине побеждает Allow. Поэтому Disallow: /catalog/ и Allow: /catalog/shoes/ означают, что раздел обуви открыт, а остальной каталог закрыт. Порядок строк при этом не имеет значения: файл не читается сверху вниз, и правило, стоящее первым, не получает преимущества.
Поддерживаются два шаблонных символа. Звёздочка обозначает любую последовательность символов: Disallow: /*?sort= закроет все адреса с параметром сортировки независимо от того, что стоит перед ним. Знак доллара означает конец адреса: Disallow: /*.pdf$ закроет PDF-файлы, но не /file.pdf?v=2. Эти символы удобны для фильтров и служебных параметров, но без проверки на реальных адресах они легко закрывают лишнее. Звёздочка в середине пути может захватить разделы, которые вы не собирались трогать, поэтому каждое такое правило стоит проверить на наборе известных адресов.
Директива Sitemap указывает абсолютный адрес карты сайта, например Sitemap: https://example.com/sitemap.xml. Она не привязана к группе User-agent и может стоять в любом месте файла. Адрес должен быть полным, с протоколом. Относительная запись вида /sitemap.xml многими парсерами не распознаётся. В файле можно указать несколько карт, и это нормальная практика для больших сайтов, где карты разбиты по разделам. Важно понимать, что строка в robots.txt не заменяет отправку карты в инструменты для вебмастеров: это разные механизмы, и надёжнее использовать оба.
Как выбрать инструмент проверки и на что смотреть в отчёте
Хороший инструмент проверки обязан правильно понимать приоритеты правил. Если он выводит список директив, но не объясняет, какое правило победит для конкретного пути, он даёт лишь иллюзию контроля. Второй критерий — возможность выбрать user-agent для симуляции конкретного робота. Без этого невозможно понять, что увидит Googlebot, а что YandexBot, ведь группы различаются. Третий критерий — прозрачность предупреждений. Инструмент должен не только сообщать о проблеме, но и показывать строку, где она возникла, и объяснять последствия. Четвёртый критерий касается технических деталей: кодировка файла, обработка редиректов на адресе robots.txt, работа с большими файлами.
Отчёт обычно делится на несколько уровней. Синтаксические ошибки означают, что строка не распознана: опечатка в названии директивы, например Dissalow вместо Disallow, или правило, записанное до первого User-agent. Такие строки парсер пропускает, и правило не работает, хотя файл на вид корректен. Предупреждения о неизвестных директивах касаются записей, которые поддерживаются не всеми роботами. Например, Clean-param и Host понимает Яндекс, но не Google. Критические блокировки — самый важный класс. Признак полной блокировки сайта — строка Disallow: / в группе, которая распространяется на всех роботов. Такая запись закрывает сайт целиком, и её обнаружение должно быть первым делом при любой проверке.

Онлайн-проверка имеет и ограничения, которые стоит держать в голове. Она проверяет правила, а не итоговую индексацию. Файл может выглядеть безупречно, но страница окажется в выдаче по внешним ссылкам, а другая — выпадет из-за noindex или проблем с содержимым. Для проверки конкретного адреса нужны инструменты, которые показывают решение робота по этому URL. В Google Search Console для этого есть проверка URL, которая сообщает, заблокирован ли адрес в файле robots.txt. Сочетание двух подходов даёт полную картину: один показывает намерение владельца сайта, другой — реальное поведение поискового робота.
Файл robots.txt не объясняет роботам, зачем закрыт раздел, и не проверяет, что там происходит. Он лишь называет границы, и любая неточность в границах превращается в закрытые страницы или утечку служебных адресов.
Как провести проверку robots.txt шаг за шагом
Работу начинают с фиксации текущего состояния. Загрузите файл с боевого домена и сохраните его копию до любых правок. Проверьте код ответа для адреса файла: должен быть 200, а не редирект на другой домен и не 5xx. Если сайт работает на нескольких поддоменах, у каждого из них свой robots.txt, и их проверяют отдельно. Поддомен shop.example.com не наследует правила основного домена, поэтому ошибка на одном из них не видна на другом.
Затем вставьте содержимое файла или укажите адрес в инструменте, выберите user-agent и разберите результаты по группам. Для каждой группы выпишите, какие разделы закрыты и какие открыты, и сравните с тем, что должно быть открыто по задачам сайта. Отдельно проверьте ключевые разделы: каталоги, посадочные страницы, служебные страницы, которые должны оставаться закрытыми, и ресурсы для рендеринга — скрипты, стили, изображения. Если закрыт каталог CSS или JavaScript, поисковик может увидеть страницу в искажённом виде и хуже оценить её содержимое. Список этих проверок стоит держать под рукой при каждом обновлении сайта.
Длительность аудита зависит от масштаба. Небольшой сайт с коротким файлом можно проверить за полчаса. Крупный портал с сотнями правил, несколькими группами роботов и сложными шаблонами требует нескольких рабочих дней, включая согласование изменений с разработчиками и тестирование на эталонном наборе адресов. Эталонный набор — это список реальных URL разных типов: страницы категорий, карточки товаров, фильтры, служебные адреса. На нём видно, как правила поведут себя на практике, а не только на бумаге. Чтобы убедиться, что нужные разделы открыты для обхода, а служебные закрыты, удобно test robots txt — бесплатный онлайн-инструмент, который показывает, как файл интерпретируется для конкретных адресов.
Типичные ошибки в robots.txt и способы их избежать
Полная блокировка сайта — самая дорогая ошибка, и причины её обычно банальны. Файл переносят с тестового сервера, где Disallow: / закрывал площадку от индексации на время разработки. Иногда ошибку вносит шаблон, в котором переменная подставляет неверное значение. Иногда после обновления CMS или плагина появляется новое правило, о котором никто не знает. Защититься помогает контроль при каждом деплое: сравнение файла с эталонной версией и автоматическая проверка после релиза, которая сигнализирует о появлении строки Disallow: / для всех роботов.
Вторая распространённая проблема — блокировка ресурсов, нужных для рендеринга. Закрытые каталоги со стилями и скриптами выглядят безобидно, но поисковик не может отрисовать страницу так, как её видит пользователь. Это влияет на оценку мобильной версии и на понимание структуры контента. Отличить нужные ресурсы от служебных просто: если файл используется для отображения страницы, его закрывать нельзя. Закрывать стоит только то, что не участвует в показе, например внутренние служебные скрипты или лог-файлы.
Третья группа ошибок связана с неочевидными совпадениями шаблонов. Регистр пути, завершающий слэш, кодировка кириллических адресов, звёздочка, захватившая лишнее, знак доллара, который не сработал из-за параметра в конце адреса — всё это приводит к тому, что правило работает не так, как задумано. Лучшая защита здесь — тестирование на эталонном наборе. Берите реальные адреса, прогоняйте их через правила и сравнивайте результат с ожиданием. Расхождения покажут слабые места быстрее, чем любая теоретическая проверка.
Что даёт онлайн-проверка и какие задачи она решает
Бесплатный анализ файла полезен прежде всего как быстрый диагностический инструмент. Вы вставляете содержимое robots.txt или указываете адрес сайта и получаете разбор директив по группам, список карт сайта и предупреждения о синтаксисе. Это позволяет за несколько минут выявить критические блокировки, которые иначе могли бы оставаться незамеченными неделями. Для владельцев сайтов, которые не работают с SEO-специалистами постоянно, такая проверка становится страховкой после каждого изменения.
Проверка корректности директив Allow, Disallow и Sitemap даёт наглядную картину приоритетов. Вы видите, какое правило побеждает для группы роботов, где конфликт и какие строки проигнорированы. Это особенно важно для сайтов с многоуровневой структурой, где правила накапливаются годами. Файл, который писали разные люди в разное время, почти всегда содержит устаревшие или противоречивые записи, и систематический разбор помогает от них избавиться.
Для тех, кто изучает чужие сайты, файл robots.txt — полезный источник информации. По нему видно, какие разделы владелец сайта счёл нужным скрыть от поиска, какие боты упомянуты отдельно и где расположены карты сайта. Это не взлом и не нарушение: файл публичен по своей природе. Но интерпретировать его стоит осторожно, потому что закрытый раздел не обязательно содержит что-то ценное, а открытый не обязательно важен.
Отдельный сценарий — ботов, работающих с искусственным интеллектом. В файле могут упоминаться GPTBot, ClaudeBot и другие. По блокам User-agent видно, разрешён или запрещён им доступ к контенту. Это решение владельца сайта, и его стоит принимать осознанно, сопоставляя с целями публикации и политикой использования материалов. Проверка файла показывает, что именно прописано, но не говорит, как каждый конкретный бот будет себя вести.
Среди ограничений инструмента стоит назвать несколько пунктов. Он не проверяет отдельный URL и не вычисляет, какое из правил сработает для конкретной страницы. Адрес берётся только в виде https://домен/robots.txt, поэтому другие протоколы и поддомены нужно вводить отдельно. А оценка по шкале от 0 до 100 — это эвристика, которая учитывает отсутствие User-agent, полное закрытие сайта, отсутствие карты и размер файла. Она не отражает оценку поисковой системы и служит лишь ориентиром.
Не стоит забывать и о временном факторе. Снимок файла фиксирует состояние на момент проверки. Поэтому после правок полезно повторно запросить сканирование и проверить, как файл обрабатывается, через отчёт в инструментах для вебмастеров.
Заканчивая разговор о файле, важно вернуться к его роли в общей картине. Robots.txt не заменяет аудит meta robots и не решает задач индексации страниц. Если закрыто лишнее, теряется трафик. Если открыто служебное, поисковик тратит ресурсы на бесполезные адреса. Баланс достигается систематической проверкой, а не разовой правкой.
Итог прост: robots.txt короткий, но его ошибки дорогие, и их легко пропустить без регулярной проверки. Начните с фиксации текущего файла и поиска критических блокировок, затем разберите группы роботов и приоритеты правил, проверьте ключевые разделы и ресурсы для рендеринга, и только после этого вносите изменения. Такой порядок действий превращает файл из источника сюрпризов в предсказуемую часть работы сайта, а проверка становится привычкой, которая экономит время и трафик.