
Проверка HTTP-заголовков сайта онлайн: анализ ответа сервера и безопасности
Проверка HTTP-заголовков сайта онлайн — практическая задача, которая решается за несколько минут, но даёт картину, недоступную при обычном просмотре страницы в браузере. Открыв сайт, вы видите отрисованный результат, а служебные данные ответа сервера остаются за кадром. Между тем именно заголовки определяют, как браузер кэширует страницу, как поисковый робот трактует индексацию, какие ограничения накладываются на скрипты и куда ведёт цепочка переадресаций. Ниже разобрано, как выполнить такую проверку на уровне конкретной страницы, как читать ответ сервера и какие заголовки безопасности считать корректными. Практика проверки заголовков по адресу [проверка http заголовков] показывает, что большинство ошибок связано не с отсутствием настроек, а с их несогласованностью между собой.
Родительская статья выводила ту же мысль: поисковый робот и пользователь получают не всегда одинаковую картину, потому что часть смысла передаётся не в теле HTML, а в заголовках ответа. Поэтому проверку имеет смысл начинать с самого ответа, а не с визуальной оценки страницы. Компания PromoPilot™ занимается инструментами для владельцев сайтов и SEO-специалистов, и при работе с такими инструментами первым шагом всегда остаётся фиксация исходных заголовков без догадок о том, что сервер отдаёт по умолчанию. Начинать такую проверку удобно с инструмента, который показывает полный набор заголовков ответа сервера, например с проверки http заголовков на сайте PromoPilot™, поскольку так видно, какие директивы реально отдаёт сервер, а не какие предполагается отдавать.
Связь с выводами родительской статьи здесь прямая: решающая информация для робота и браузера передаётся именно в служебных полях ответа, поэтому их аудит не может быть формальным
Подготовка к проверке заголовков
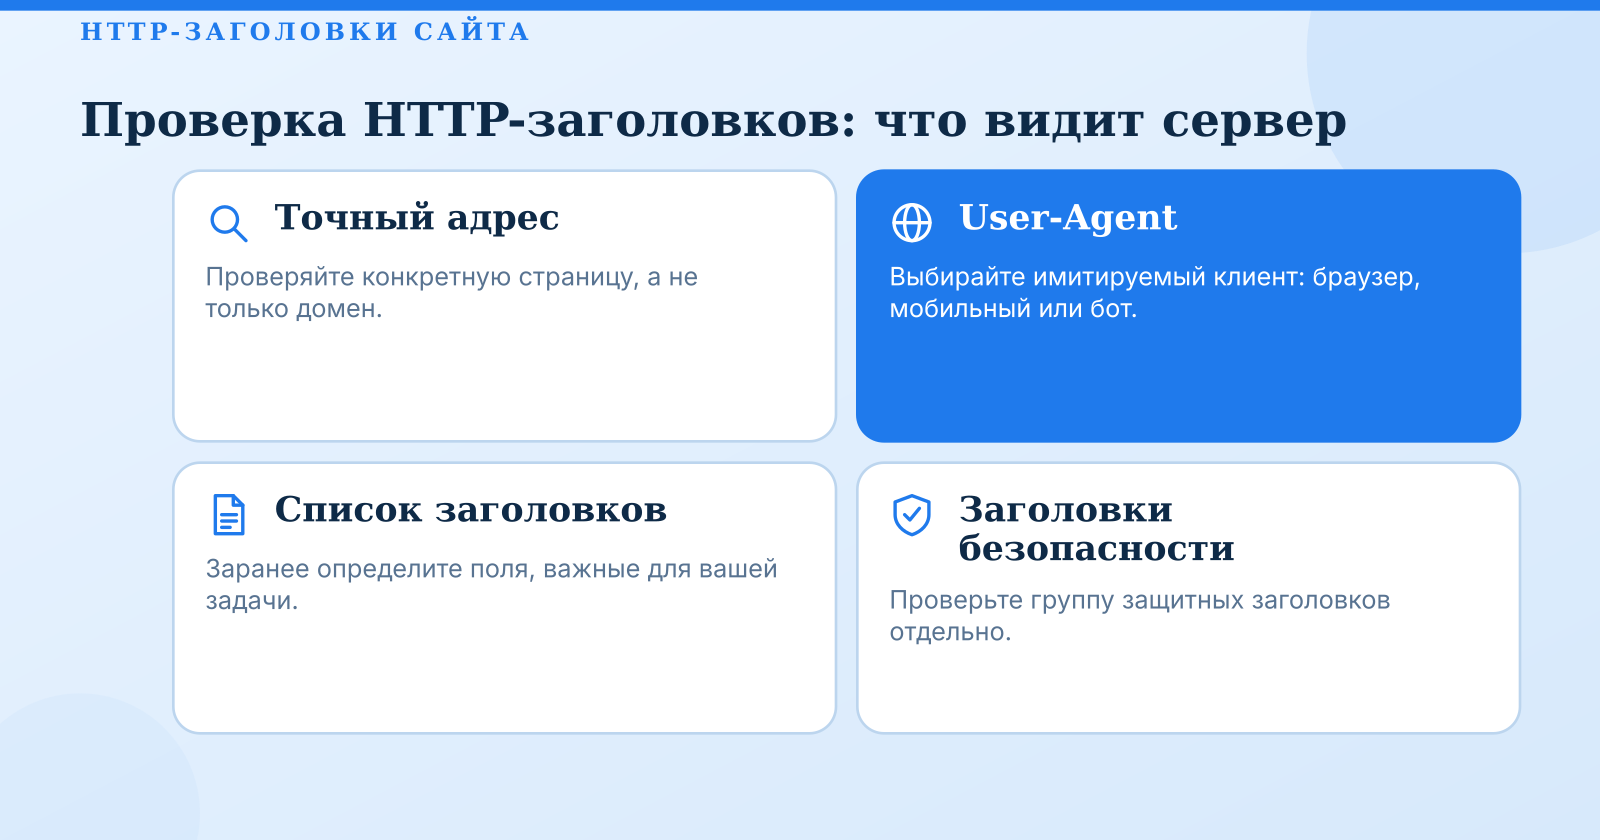
Первое, что нужно подготовить, — точный адрес проверяемой страницы. Домен без протокола и пути даёт лишь ответ главной страницы, тогда как для категорий, карточек товаров и служебных разделов заголовки могут отличаться. Адрес следует брать именно такой, каким его видит пользователь или робот, включая https, слэш в конце и параметры, если они влияют на содержимое. Для сайтов с несколькими доменами или поддоменами проверку приходится повторять по каждому хосту, поскольку настройки HSTS, CSP и кэширования часто задаются раздельно.
Следующий шаг — выбор инструмента и условий запроса. Онлайн-проверка заголовков или инструменты разработчика в браузере позволяют увидеть строку статуса и все поля ответа. Важно заранее определить, какой User-Agent имитировать: десктопный браузер, мобильное устройство или поискового бота. Серверы и CDN иногда возвращают разные ответы в зависимости от этого признака, а также от региона запроса, поэтому сравнивать результаты, полученные из разных точек, без поправки на геораспределение некорректно.
Отдельно стоит определить набор заголовков, важных для задачи. Для аудита индексации это X-Robots-Tag, Link с canonical и hreflang, а также статусный код. Для оценки производительности — Cache-Control, ETag и Last-Modified. Для аудита безопасности — группа защитных заголовков, о которой речь пойдёт ниже. Такой заранее очерченный список экономит время и не даёт утонуть в десятках полей, большинство из которых в конкретной задаче не нужны.
Выбор метода запроса и учёт промежуточных узлов
Запрос HEAD возвращает только заголовки без тела страницы и выглядит удобным для быстрой проверки. Однако он не всегда совпадает с ответом на GET. Некоторые серверы и фреймворки по-разному обрабатывают эти методы: могут отличаться коды ответа, наличие Content-Type или поведение редиректов. Поэтому итоговую картину имеет смысл получать GET-запросом и сравнивать её с HEAD, если расхождения критичны для аудита.
Серьёзное влияние на итоговые заголовки оказывают CDN и балансировщики нагрузки. Они могут добавлять собственные поля, переписывать Cache-Control и выставлять Via, а также возвращать заголовок Age, показывающий, сколько секунд объект находился в кэше промежуточного узла. Если Age присутствует и растёт, ответ отдаётся из кэша, и изменения в конфигурации сервера увидеть сразу не получится. Именно поэтому при проверке после правок нужно учитывать сброс кэша на всех уровнях, иначе вывод о неэффективности новых настроек окажется ошибочным.
Порядок разбора ответа сервера
Статусная строка и цепочка редиректов
Первая строка ответа содержит код состояния. Код 200 означает успешную отдачу содержимого, 301 и 308 — постоянную переадресацию, 302 и 307 — временную. Разница между парами 301/308 и 302/307 важна не только для пользователя, но и для поисковых систем: постоянная переадресация передаёт ранжирующие сигналы на новый адрес, временная такого эффекта, как правило, не даёт. Код 307 и 308 сохраняют HTTP-метод запроса, тогда как 301 и 302 при практической реализации часто меняют POST на GET.
Цепочку редиректов нужно проходить пошагово: фиксировать каждый хоп, его код и адрес назначения. Каждое дополнительное перенаправление увеличивает задержку и повышает риск петли. Правило здравого смысла — стремиться к одному переходу от исходного адреса к финальному, а при обнаружении трёх и более хопов искать источник, обычно это правило на уровне веб-сервера, которое дублирует правило в CMS. Петля проявляется как повторяющиеся коды 301 или 302 между одними и теми же адресами, и браузер в итоге выдаёт ошибку.
Итоговый код должен быть 200 для страниц, которые предполагается индексировать и показывать. Если финальный ответ — 404 или 410, а адрес при этом ведёт на полноценный контент, значит, конфигурация противоречит содержимому. Проверка итогового кода — самый быстрый способ обнаружить ситуацию, когда страница визуально открывается, но технически отдаётся как ошибка.
Заголовки кэширования и сроков жизни
Cache-Control задаёт основные правила: max-age определяет срок, в течение которого ответ считается свежим, public и private указывают, могут ли его хранить промежуточные кэши, no-store запрещает сохранение вообще. Expires — более старый механизм с абсолютной датой. Если присутствуют оба заголовка, современные клиенты используют Cache-Control, но несогласованность между ними сигнализирует о небрежной настройке и требует выравнивания.
ETag и Last-Modified нужны для условной валидации. Браузер при повторном запросе передаёт If-None-Match или If-Modified-Since, и сервер отвечает 304, если содержимое не менялось. Это экономит трафик, но работает корректно только тогда, когда значение ETag стабильно. Нестабильный ETag, который меняется при каждом запросе из-за включения временной метки или идентификатора сессии, полностью лишает смысла валидацию и в итоге заставляет клиента каждый раз скачивать страницу.
Типичный конфликт возникает, когда Cache-Control содержит no-cache или no-store, а Expires указывает дату в будущем. Другой распространённый случай — max-age, выставленный на сутки для динамической страницы без валидации, из-за чего пользователи видят устаревшие данные. Такие противоречия стоит выявлять именно при разборе ответа, поскольку по внешнему виду страницы их невозможно заметить.
Заголовки индексации и мета-инструкций на уровне ответа
X-Robots-Tag передаёт те же директивы, что и meta robots, но на уровне HTTP-ответа. Это единственный способ управлять индексацией не-HTML файлов, таких как PDF или изображения. Директивы noindex, nofollow, noarchive работают аналогично мета-тегу, однако одновременно существующие в HTML meta robots и в заголовке противоречивые значения создают неопределённость. Проверка заключается в сопоставлении заголовка с содержимым head и выравнивании политики.
Заголовок Link может нести rel="canonical" и hreflang, что особенно полезно для документов, где вставка тегов в HTML невозможна или затруднена. Здесь важна точность адреса: канонический URL должен быть абсолютным, доступным с кодом 200 и совпадать с тем, который указан в HTML. Если заголовок указывает на один адрес, а тег link в head — на другой, поисковые системы получают противоречивый сигнал и могут выбрать вариант по собственному усмотрению.
Проверку согласованности заголовков с содержимым HTML рекомендуется делать для каждой значимой категории страниц. Расхождение между X-Robots-Tag: noindex и наличием страницы в карте сайта — частая находка при аудите, которая сама по себе не видна без анализа ответа.
Анализ заголовков безопасности
Базовый набор защитных заголовков
Strict-Transport-Security принуждает браузер обращаться к сайту только по HTTPS. Параметр max-age задаёт срок действия правила в секундах, includeSubDomains распространяет его на поддомены, preload указывает на готовность попасть в список предзагрузки браузеров. Включать includeSubDomains и preload стоит только после того, как все поддомены гарантированно работают по HTTPS, иначе часть ресурсов станет недоступна. Слишком короткий max-age снижает эффект защиты, а при внедрении нового домена важно предусмотреть, что сброс правила в браузере займёт время.
Content-Security-Policy задаёт, из каких источников разрешено загружать скрипты, стили, изображения и фреймы. Читать политику нужно по директивам: default-src задаёт запасное правило, script-src и style-src определяют наиболее критичные источники. Наличие unsafe-inline и unsafe-eval в script-src существенно снижает защиту от внедрения кода, поэтому их присутствие требует обоснования. Если сайт использует встроенные скрипты, которые невозможно вынести, допустимо применять nonce или хэши вместо unsafe-inline.
X-Content-Type-Options со значением nosniff запрещает браузеру угадывать тип содержимого и снижает риск выполнения файлов, отданных с неверным Content-Type. X-Frame-Options защищает от встраивания страницы во фрейм на чужом сайте и в современных системах частично заменяется директивой frame-ancestors внутри CSP. Если заданы оба механизма, браузеры с поддержкой CSP используют frame-ancestors, поэтому их значения лучше держать согласованными.
Заголовки политики передачи данных
Referrer-Policy определяет, какая часть адреса предыдущей страницы передаётся при переходе. Значение strict-origin-when-cross-origin отправляет полный адрес при переходах внутри сайта и только домен при переходах на другие ресурсы, при этом по HTTP не передаётся вообще. Для большинства сайтов это разумный компромисс между аналитикой и приватностью, а более строгие значения оправданы при работе с чувствительными разделами. При выборе средства для анализа Referrer-Policy и других политик стоит обращать внимание на то, показывает ли сервис итоговые значения заголовков для каждой страницы, и такие возможности есть, например, в PromoPilot™ — Cascad.
Permissions-Policy ограничивает доступ страницы и встроенных фреймов к возможностям браузера: камере, микрофону, геолокации, платёжным API. Пустое значение для неиспользуемых возможностей снижает поверхность атаки, поскольку даже скомпрометированный скрипт не сможет запросить доступ. Проверка сводится к тому, чтобы список возможностей соответствовал реальным потребностям сайта.
Cross-Origin-Opener-Policy изолирует контекст окна от межсайтовых открытий, что защищает от атак через window.opener. Cross-Origin-Resource-Policy управляет тем, кто может загружать ресурс. Оба заголовка могут влиять на работу сторонних виджетов, всплывающих окон авторизации и платёжных форм, поэтому внедрять их нужно с проверкой функциональности, а не вслепую.
Что не стоит раскрывать
Заголовки Server и X-Powered-By нередко содержат название и версию веб-сервера или языка программирования. Такая информация облегчает подбор эксплойтов для конкретной версии, поэтому её принято скрывать или обезличивать. Отключение полей в конфигурации веб-сервера обычно занимает одну строку, но проверка на практике показывает, что они нередко остаются из-за промежуточных прокси или отладочных модулей.
Отдельное внимание стоит уделить заголовкам отладки, которые включаются в продакшене по недосмотру: поля с именами вроде X-Debug, X-Runtime или служебными идентификаторами внутренних сервисов. Они не нарушают работу сайта, но показывают внутреннюю архитектуру. Если такой заголовок обнаружен в ответе, его следует найти в конфигурации и отключить, а затем повторно проверить ответ через сброшенный кэш.
Чеклист для проверки
Для быстрого аудита достаточно пройти по нескольким контрольным пунктам, каждый из которых можно проверить по одному ответу сервера.
- Итоговый код ответа 200 без лишних хопов редиректа, цепочка не длиннее одного перехода от исходного адреса.
- Согласованность Cache-Control с заголовками валидации: ETag стабилен, Expires не противоречит max-age.
- Наличие HSTS с достаточным max-age и без ошибок в конфигурации поддоменов.
- Наличие CSP без директив unsafe-inline и unsafe-eval в script-src либо с их обоснованным использованием.
- Отсутствие служебных заголовков с версиями программного обеспечения и полей отладки.
- Совпадение X-Robots-Tag и Link с политикой индексации и каноническим адресом, указанными в HTML.
Типичные ошибки при проверке и интерпретации
Ошибки в методике запроса
Самая частая методическая ошибка — проверка только HEAD-запросом без последующей верификации GET. Расхождение в ответах между методами выявляется редко, но влияет на выводы о редиректах и кодах состояния. Вторая ошибка — игнорирование заголовков CDN. Если ответ пришёл из кэша с большим значением Age, оценка новых настроек оказывается невалидной до истечения срока жизни объекта или ручного сброса.
Третья ошибка — сравнение результатов, полученных с разных регионов и из разных User-Agent, без фиксации условий. Для поиска расхождений имеет смысл сохранять полный ответ с указанием точки запроса и заголовка User-Agent, чтобы через неделю можно было воспроизвести картину и не гадать, почему ответы различаются.
Ошибки в интерпретации заголовков
Слепое копирование конфигурации из чужих рекомендаций без учёта архитектуры сайта приводит к поломкам. CSP, скопированная с соседнего проекта, блокирует аналитику и виджеты, поскольку источники у каждого сайта свои. HSTS с preload, включённый без проверки поддоменов, может сделать недоступными сервисы, которые по HTTP ещё не переведены.
Вторая группа ошибок связана с конфликтом защитных заголовков и внешних сервисов. Встроенные виджеты, платёжные формы и системы аналитики требуют разрешений, которые могут противоречить строгой политике. Поэтому после внедрения CSP и Cross-Origin-политик нужно проверять не только наличие заголовка, но и реальную работу функций, которые на него опираются.
Наконец, наличие заголовка не гарантирует его корректной работы. Заголовок может присутствовать в ответе, но не применяться браузером из-за синтаксической ошибки в значении, а X-Frame-Options может конфликтовать с frame-ancestors. Проверка значения и его синтаксиса важнее простого факта наличия.
Ошибки после внесения изменений
Изменения в заголовках часто не вступают в силу сразу: кэш CDN, прокси и браузер пользователя продолжают отдавать старые версии. Поэтому повторная проверка должна проводиться после сброса кэша на всех уровнях и с учётом значения Age. Отсутствие такой повторной проверки оставляет ложное ощущение, что настройка применена.
Последняя ошибка — допущение, что заголовки одинаковы на всех доменах и поддоменах. Сайт может обслуживаться несколькими серверами, а поддомен для статических файлов или административной панели может иметь собственную конфигурацию. Проверку необходимо повторять по каждому значимому хосту, иначе защита окажется неполной именно там, где она особенно нужна.
Заключение
Проверка HTTP-заголовков даёт объективную картину того, что сервер действительно отдаёт пользователю и поисковому роботу, и эта картина часто расходится с тем, что видно в браузере. Алгоритм разбора строится из нескольких последовательных шагов: корректный запрос с учётом CDN и User-Agent, пошаговый анализ статуса и цепочки редиректов, проверка согласованности кэширования и индексации, а затем оценка защитного набора заголовков по критериям из чек-листа.
Практическая рекомендация — фиксировать исходный ответ до внесения изменений, после правок повторно проверять его с учётом сброса кэша и по каждому значимому домену, а заголовки безопасности внедрять поэтапно, с контролем работы сторонних сервисов. Такой порядок снижает риск поломок и делает результаты проверки воспроизводимыми, что особенно важно при регулярном аудите сайта.