
KaggleのTesla T4で、Qwen-Image-2.1 Standard INT8をComfyUIから実行し、画像生成に成功しました。
解像度1024 × 1024、25ステップの設定で、最初の3回のワークフロー実行時間は184〜193秒。使用中のGPUで観測したVRAM使用量の最大値は約14.34 GiBでした。
最初に生成したのは、赤いティーポットと白いカップの画像です。その後、別のプロンプトでも2回生成し、いずれも正常に完了しました。さらに、モデルを保存した非公開Kaggle Datasetを新しいセッションに接続し、重みを再ダウンロードせずに画像を生成できることも確認しました。
この記事では、KaggleでQwen Imageを動かすために使用した構成、実測値、途中で発生した問題をまとめます。T4は2枚利用可能でしたが、今回の推論で使われたのはGPU 0のみで、GPU 1はほぼ待機状態でした。
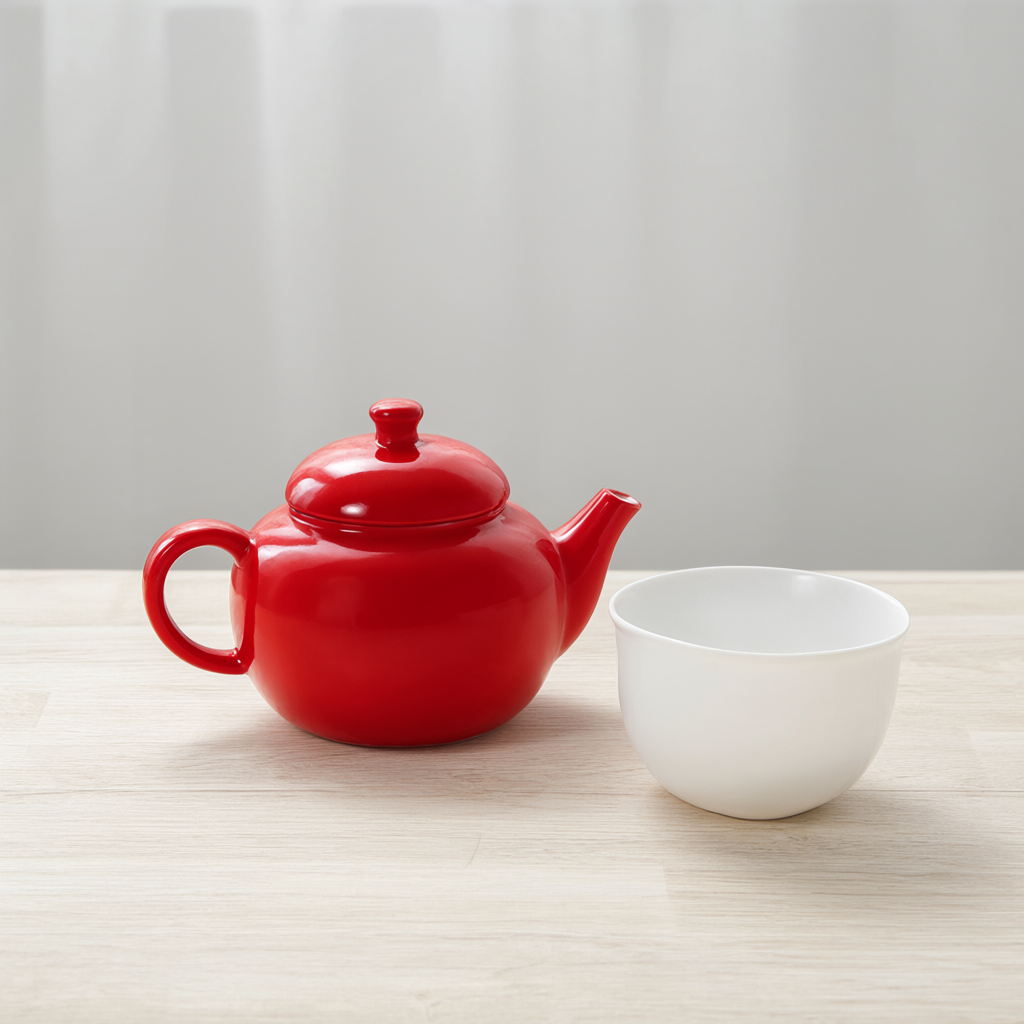
最初に生成したティーポットとカップの画像。解像度1024 × 1024、25ステップ。
それまでの試行:GGUF、CPUオフロード、Turbo
今回のKaggleでのQwen Image実測に先立ち、Museを使った試行では、次の3つの構成が試されていました。
- V4: GGUF形式のDiTと8ビットのテキストエンコーダーを使用。読み込み後に、異なるデバイス間のテンソル処理でエラーが発生しました。
- V6: GPUを1枚に限定し、CPUオフロードを使用。画像生成中にGPUメモリが不足しました。
- Turbo構成: ComfyUI用の3ファイルをダウンロードしたものの、約1時間半待っても正常に起動しませんでした。
これらは以前の試行についての記録に基づくもので、当時のログは再確認していません。今回の作業では、古いセッションがまだ動いていたことを確認し、停止しました。
新しい試行では、Standard INT8とComfyUIの公式ワークフローに構成を絞りました。量子化形式、GPUへの配置、サンプリング設定を揃え、モデルの読み込みから画像の保存まで、一つの構成を通して検証する方針です。
Kaggleでのモデルダウンロードとセッション切り替え
当初はGPU時間を節約するため、CPUセッションでモデルをダウンロードしてからGPUに切り替える予定でした。
ファイルの合計サイズは約17 GB。ダウンロード後に「Files only」を有効にしてGPUへ切り替えたところ、古いセッションのファイルをアップロードする処理で待機状態になりました。約12分経過しても、明確な進展は見られませんでした。
そこで、GPUセッション内でQwen Imageのモデルを直接ダウンロードする方法に変更しました。容量が約20 GBだった作業ディレクトリを埋めないよう、空き容量の多い一時ディレクトリを使用しました。以前のCPUセッションにあるファイルは、そのまま残しました。
ダウンロード完了後は、ComfyUIを起動する前にファイルのハッシュを確認しました。
また、別の理由で手動停止した場面もありました。当初設定していた作業全体の20分という制限に近づいたため、いったん処理を停止したのです。その後、時間制限を解除し、ディスク上にあるファイルを使って再開しました。この中断は時間制限によるもので、GPUメモリ不足による停止ではありませんでした。
動作したQwen Image INT8のモデルとComfyUI設定
Kaggleで正常に動作した構成では、Comfy-Org/Qwen-Image-2.1から次の3ファイルを使用しました。これはQwenのオリジナルモデルをComfyUI向けにまとめたものです。
- qwen_image_2.1_int8_convrot.safetensors
- qwen3vl_8b_int8_convrot.safetensors
- qwen_image_2.1_vae_bf16.safetensors
最初の2つが拡散モデルとテキストエンコーダー、3つ目がVAEです。この記事ではStandard INT8構成と呼んでいますが、VAEの精度はBF16のままです。
KaggleのT4でQwen Imageを実行する際は、ComfyUIに --lowvram と --force-fp16 を指定しました。ログ上でも、低VRAMモードと動的VRAM管理が有効になっていることを確認しました。
最初の3回は、以下の設定を共通にし、プロンプトだけを変更しました。
| パラメーター | 設定値 |
|---|---|
| 解像度 | 1024 × 1024 |
| ステップ数 | 25 |
| バッチサイズ | 1 |
| CFG | 1 |
| サンプラー/スケジューラー | euler/simple |
| Denoise | 1 |
| Seed | 593103825222985 |
ワークフローは、モデルの読み込み、プロンプトのエンコード、サンプリング、VAEによるデコード、PNG保存の順で進みます。
実行前には必要なノードが利用可能かを確認しました。各実行後には、処理が正常に終了したこと、PNG全体を読み込めること、画像サイズが設定どおりであることを確認しています。
KaggleでのQwen Image生成速度とVRAM使用量
最初のプロンプトは、テーブルの上に置かれた小さな赤い陶器のティーポットと、その隣にある白いカップというシンプルな静物でした。プロンプトから保存画像までの処理を確認するための題材です。
その後、同じ設定で人物アート系のプロンプトを2つ試しました。どちらもメモリ不足のエラーなく完了し、出力を確認しました。この2枚は記事には掲載していません。
最初の3回の実測値は次のとおりです。
| 実行 | ComfyUIワークフロー時間 | スクリプトで記録した合計時間 | GPU 0の観測最大VRAM |
|---|---|---|---|
| 1枚目 | 192.57秒 | 207.41秒 | 14683 MiB |
| 2枚目 | 188.57秒 | 211.39秒 | 14681 MiB |
| 3枚目 | 184.42秒 | 200.37秒 | 14681 MiB |
Kaggle上のQwen Imageワークフロー自体は、1回あたり約3分でした。サービス起動、完了待ち、出力確認まで含めると、約3分20秒〜3分30秒です。
この合計時間には、モデルのダウンロードと依存関係のインストールは含めていません。また、ワークフロー時間はサンプリングだけでなく、ComfyUIのワークフロー全体を対象にしています。
GPUメモリは約2秒間隔で取得し、各実行のサンプル数は101、103、98でした。観測した最大使用量は約14.34 GiBです。サンプル間に発生した短いピークは記録されていない可能性があります。
GPUの使われ方も明確でした。GPU 0は観測時の使用率が100%に達しましたが、GPU 1はメモリ使用量が約3 MiB、使用率が0%のままでした。T4を2枚使える環境でも、今回のQwen Image構成は実質的に単一GPUで動作していました。
システムRAMについては、ログに約30 GiBの上限が表示されていました。最初の3回ではプロセスの最大メモリ使用量を記録していないため、実測ピーク値はありません。
Qwen Imageのモデルを非公開Kaggle Datasetに保存する
画像生成に成功した後、3つのモデルファイルとマニフェストを、非公開のKaggle Datasetに保存しました。
DatasetのVersion 1には4ファイルが含まれ、合計サイズは約17.28 GBでした。生成画像は保存していません。
Datasetの接続では、最初にエラーが発生しました。アップロードとサーバー側の処理が完了した後、SDKからの接続で次のメッセージが返されました。
Failed to get session
Notebookの「Add Input」でも、一時的に次のエラーが表示されました。
An error occurred updating the session
最終的にはDatasetを接続できました。マウントされたモデルファイルを読み込み、SHA256ハッシュを計算したところ、3ファイルすべてが元のファイルと一致しました。マニフェストも一致し、入力ディレクトリが読み取り専用であることも確認しました。
ここまでで確認できたのは、保存したQwen Imageのファイルが元のセッションから正しく利用できることです。次に、新しいセッションでも画像生成まで完了するかを試しました。
新しいGPUセッションでQwen Imageを再実行する
新しいKaggleセッションでは、以前のComfyUIディレクトリが存在しないことを最初に確認しました。
その後、非公開Datasetを接続し、3つのモデルファイルのハッシュを再確認しました。検証済みのファイルから、ComfyUIが参照する場所へシンボリックリンクを作成しています。
新しいセッションでも実行環境の準備は必要でしたが、モデルの重みを外部からダウンロードする処理はありませんでした。最初のティーポットと同じプロンプト、同じサンプリング設定で、再び画像を生成できました。
| 新規セッションでの計測項目 | 時間 |
|---|---|
| 環境とモデルの準備 | 140.48秒 |
| ComfyUIワークフロー実行 | 168.44秒 |
| サービス起動から出力確認まで | 199.37秒 |
| 準備開始から確認完了までの全体 | 341.78秒 |
新しいセッションでの全体時間は、約5分42秒でした。Kaggleのキュー待ちやセッション割り当て待ちは含めていません。
また、ワークフロー実行時間は「サービス起動から出力確認まで」に含まれています。表の4行を足し合わせるものではありません。
この再利用テストでは、GPU 0の観測最大VRAM使用量は14753 MiBでした。GPU 1は約3 MiBのままで、今回も実質的に単一GPUでの推論でした。
新しく生成したティーポット画像を元の画像とピクセル単位で比較したところ、ピクセルは完全に一致しました。 PNGファイルのハッシュは異なりましたが、出力名などの埋め込みメタデータが異なっていたためです。この比較結果は、記録した環境で生成した2枚についてのものです。
これで、非公開Datasetの接続、ファイル検証、画像生成、出力確認まで、新しいKaggleセッションで一通り実行できました。テスト後はGPUセッションを停止しました。
Qwen Image実測時のバージョンとリビジョン
正常に動作したKaggle環境のバージョンは以下のとおりです。
- Python:3.13.16
- PyTorch:2.11.0+cu130
- ComfyUI:0.37.0
- comfy-kitchen:0.2.35
- comfy-aimdo:0.5.5
- Attention:PyTorch attention
- ComfyUIコミット:93810483a4739a1588236919a3128d3070244146
- モデルリビジョン:aacf31a6d48e707f352ecba714cee0680da3479b
- 公式ワークフローのリビジョン:a7acaf8cee9ccccdaf4b26ce04a9fced4c4d13de
この記事の実測値は、最初の3回の画像生成レポートと、新規セッションでの再利用テストに基づいています。
ログ、ワークフロー、環境のバージョン、インストール済みパッケージ一覧は保存しました。ただし、すべての依存関係を固定したわけではないため、環境を変更した場合は再確認が必要です。
今回のKaggle Qwen Image構成で確認できたこと
今回確認した条件は、1024 × 1024、25ステップ、1回につき1枚の画像生成です。
GPUセッション内で直接モデルをダウンロードし、ハッシュを確認して、同じ設定で実行することで生成に成功しました。その後は、非公開Datasetからモデルを読み込むことで、重みを再ダウンロードせずに新しいセッションでも再実行できました。
より高い解像度、大きなバッチサイズ、2枚目のGPUを使った推論は、まだ試していません。今回の構成は、それらを検証する際に比較できる動作済みの基準になります。
生成した画像をWebサイトで公開する場合は、画像プレビューから実際の利用につなげるガイドで、画像を説明する文脈と、画像を開いた後に訪問者ができることを整理しています。